

Appearance
认识 RuoYi Vue Pro 的 AI 模块:功能、数据表与实现现状
上一篇我们已经接入了一个真实模型,并从现有 AI 聊天页面完成了一次真实对话。
但刚才真正接触到的,其实只是 yudao-module-ai 中的模型管理和聊天能力。
打开整个 AI 模块以后,还可以看到知识库、图片、音乐、写作、思维导图、工作流、Tool、MCP 等一系列能力。
我们可以实际去打开页面点击查看一下,通过前端实际页面功能来了解整个业务,对我们后续代码阅读有很大帮助。
了解完实际页面功能以后,这篇文章我们就来整体了解一下 AI 模块的底层设计。
先看 AI 模块的整体版图
模型能力是整个模块的底座
AI 模块整体上分为两部分:
text
                         AI 模块
                            │
                    ┌───────┴───────┐
                    │               │
               模型与凭证         AI 业务能力
                    │               │
          ┌─────────┴──────┐        ├── Chat
          │                │        ├── Knowledge / RAG
      API Key            Model      ├── Image
                                   ├── Music
                                   ├── Write
                                   ├── MindMap
                                   └── Workflow
                                            │
                                  Tool / MCP / LLM
API Key 和 Model,我们上一篇已经真正使用过:
text
ai_api_key
    ↓
保存模型平台、密钥、API 地址

ai_model
    ↓
保存具体模型和模型参数
后面的 Chat、知识库、图片、写作等功能,会围绕现有的模型配置来实现,共用一套底层模型调用能力。
AI 模块现在分成哪些功能区域
目前主要业务已经明确拆成:
text
Model
Chat
Knowledge
Image
Music
Write
MindMap
Workflow
其实已经逐步形成了一套比较完整的 AI 应用能力。
大概分为四层:
text
第一层:模型接入
API Key / Model

第二层:AI 交互
Chat / Role / Tool / MCP

第三层:AI 应用
Knowledge / Image / Music / Write / MindMap

第四层:AI 编排
Workflow
后面我们做 CostFlow 的时候,其实并不会太关注这些上层业务的具体实现,比如说 RAG 如何保证召回率。这些会留到后续其他项目中重点分析。当前我们也不会对上游开源项目做业务层面的侵入式改造,更多还是先分析整体流程,再实现 CostFlow 的功能。
AI 模块有哪些数据库表
按照当前源码中所有 AI Data Object 的 @TableName 来统计,一共有 14 张 AI 业务表。
模型与密钥相关表
模型相关目录中有:
| 表 | 作用 |
|---|---|
ai_api_key | 保存模型平台、API Key、自定义 API 地址 |
ai_model | 保存具体模型及模型参数 |
ai_chat_role | 保存聊天角色、System Prompt、模型、知识库、Tool 等配置 |
ai_tool | 保存可以提供给模型调用的 Tool |
其中 ai_chat_role 已经不仅仅是“角色名称 + Prompt”。
它还能够关联:
text
modelId
knowledgeIds
toolIds
mcpClientNames
也就是说,一个角色本身就可以继续组合:
text
模型
+
知识库
+
Tool
+
MCP Client
+
System Prompt
聊天与对话相关表
Chat 部分实际上只有两张核心表:
| 表 | 作用 |
|---|---|
ai_chat_conversation | 保存一次持续对话的配置 |
ai_chat_message | 保存对话中的每一条用户或模型消息 |
这两张表的关系非常简单:
text
ai_chat_conversation
        │
        │ 1
        │
        └──────── N
                  │
          ai_chat_message
一次 Conversation 可以拥有很多条 Message。
这也是我们上一篇真正完成一次聊天以后,数据库里会同时产生对话记录和消息记录的原因。
知识库相关表
知识库目前拆成三层:
| 表 | 作用 |
|---|---|
ai_knowledge | 知识库本身 |
ai_knowledge_document | 一个知识库中的文档 |
ai_knowledge_segment | 文档进一步切出来的文本片段 |
所以它的数据关系是:
text
Knowledge
    │
    ├── Document A
    │      ├── Segment 1
    │      ├── Segment 2
    │      └── Segment 3
    │
    └── Document B
           ├── Segment 1
           └── Segment 2
这就是一个比较典型的 RAG 数据结构。
并且知识库目录中还有单独的 retrieval 功能。
图片、音乐与写作相关表
这几类功能目前基本采用“一种业务对应一张主表”的方式:
| 功能 | 表 |
|---|---|
| AI 绘图 | ai_image |
| AI 音乐 | ai_music |
| AI 写作 | ai_write |
| 思维导图 | ai_mind_map |
这些表都可以从当前代码中的 DO 直接确认。
例如 ai_image 不只是保存一张图片 URL。
它还保存:
text
userId
prompt
platform
modelId
model
width
height
status
finishTime
errorMessage
picUrl
options
taskId
这里已经能看到一种比较典型的 AI 任务模型:
text
用户提交任务
    ↓
记录模型与参数
    ↓
进入生成状态
    ↓
等待外部模型完成
    ↓
保存结果 / 错误信息
AI 音乐也很相似,表里已经包含 title、lyric、audioUrl、videoUrl、status、platform、model、taskId、errorMessage 等信息。
工作流与工具相关表
Workflow 当前使用:
text
ai_workflow表保存工作流。
核心字段包括:
text
name
code
graph
remark
status
其中 graph 直接保存工作流图的 JSON 数据。
Tool 则使用:
text
ai_tool保存工具名称、描述和状态。
当前源码甚至已经直接给出了 directory_list、weather_query 这样的 Tool Bean 示例。
看懂几张最核心的表
14 张表我们没必要现在全部逐字段分析。
对于后面的 CostFlow,我们先认识最重要的几张。
ai_api_key:模型服务凭证
ai_api_key 保存访问模型平台所需要的凭证和地址。
| 字段 | 说明 |
|---|---|
id | API Key 记录的唯一标识,供模型配置关联 |
name | 这条凭证在管理端显示的名称 |
apiKey | 访问模型平台所使用的密钥 |
platform | 模型平台,例如 DeepSeek、OpenAI 或 Anthropic |
url | 自定义 API 地址,适合兼容接口、中转服务或自部署服务 |
status | 当前凭证是否启用 |
这张表解决的是“通过哪个平台地址和凭证访问模型”,并不负责描述具体使用哪个模型。
ai_model:具体模型配置
真正描述具体模型的是 ai_model。除了模型本身的信息,它还保存聊天模型需要的参数。
| 字段 | 说明 |
|---|---|
id | 模型配置的唯一标识 |
keyId | 关联 ai_api_key 的凭证标识 |
name | 管理端展示的模型名称 |
model | 调用接口时实际使用的模型标识,例如 deepseek-flash |
platform | 模型所属平台 |
type | 模型类型,例如聊天、图像、音频或向量 |
sort | 同类模型在管理端或选择列表中的排序值 |
status | 当前模型是否启用 |
temperature | 生成内容时使用的温度参数 |
maxTokens | 单次回复允许生成的最大 Token 数 |
maxContexts | 对话中允许保留的上下文消息数量 |
其中:
text
keyId关联刚才的 ai_api_key。
所以最基础的数据关系是:
text
ai_api_key
      │
      │ 1
      │
      └────── N
              │
          ai_model
一个凭证可以服务多个模型。
ai_chat_conversation:一次对话怎么保存
ai_chat_conversation 保存的是一次长期对话,而不是一条消息。
它的核心字段可以分成三部分:对话归属、模型配置和对话展示状态。
| 字段 | 说明 |
|---|---|
userId | 创建或拥有这次对话的用户标识 |
title | 对话标题 |
pinned | 是否置顶 |
pinnedTime | 置顶时间 |
roleId | 使用的聊天角色标识,可为空 |
modelId | 创建对话时选择的模型配置标识 |
model | 对话实际使用的模型标识 |
systemMessage | 当前对话的角色设定或系统提示词 |
temperature | 当前对话使用的温度参数 |
maxTokens | 当前对话单次回复的最大 Token 数 |
maxContexts | 当前对话保留的上下文消息数量 |
模型参数会从 ai_model 带到 Conversation 中。
所以即使以后 Model 配置发生变化,已经创建的对话仍然拥有自己当时的:
text
model
temperature
maxTokens
maxContexts
配置。
可以简单理解成:
text
Model
  ↓
创建 Conversation
  ↓
复制一部分模型配置
  ↓
之后这个 Conversation 按自己的配置聊天
这也是为什么上一篇我们能够在单独某个聊天中重新切换模型和参数。
ai_chat_message:一条消息保存了什么
接下来这张表对 CostFlow 非常重要。
当前 AiChatMessageDO 中和一次调用直接相关的字段包括:
| 字段 | 说明 |
|---|---|
conversationId | 所属对话的标识 |
replyId | 用于关联对应回复消息的标识 |
type | 消息类型,例如用户消息或模型消息 |
userId | 产生这条消息的用户标识 |
roleId | 使用的聊天角色标识 |
model | 这条消息使用的模型标识 |
modelId | 这条消息使用的模型配置标识 |
content | 消息正文或模型回复内容 |
reasoningContent | 模型返回的思考过程内容,如果有的话 |
useContext | 本次请求是否携带上下文 |
segmentIds | 本次回答使用到的知识库片段标识 |
webSearchPages | 本次回答使用到的联网搜索页面信息 |
attachmentUrls | 消息携带的附件地址 |
例如一次普通对话:
text
user
“帮我解释一下 RAG”
        │
        ▼
ai_chat_message
type = user

        ↓ 模型回复

ai_chat_message
type = assistant
content = "..."
replyId 则可以把模型回复和对应的用户消息关联起来。
同时,一条消息还能够保存:
text
使用了哪些知识库 Segment
进行了哪些联网搜索
携带了哪些附件
这已经不再是一个只能保存纯文本的聊天记录表。
知识库相关表之间是什么关系
这三张表分别对应知识库、文档和文档切片。
ai_knowledge:知识库本身
| 字段 | 说明 |
|---|---|
name | 知识库名称 |
description | 知识库说明 |
embeddingModelId | 使用的 Embedding 模型配置标识 |
embeddingModel | 使用的 Embedding 模型标识 |
topK | 检索时返回的候选片段数量 |
similarityThreshold | 片段被认为相关时需要达到的相似度阈值 |
status | 知识库是否启用 |
ai_knowledge_document:知识库中的文档
| 字段 | 说明 |
|---|---|
knowledgeId | 所属知识库的标识 |
name | 文档名称 |
url | 文档或原始文件地址 |
content | 文档解析后的文本内容 |
contentLength | 文档内容长度 |
tokens | 文档内容对应的 Token 数量 |
segmentMaxTokens | 切分文档时单个片段允许的最大 Token 数 |
retrievalCount | 文档被检索命中的次数 |
status | 文档当前状态 |
ai_knowledge_segment:文档切分后的文本片段
| 字段 | 说明 |
|---|---|
knowledgeId | 所属知识库的标识 |
documentId | 所属文档的标识 |
content | 当前片段的文本内容 |
contentLength | 当前片段的内容长度 |
vectorId | 向量存储中的对应标识 |
tokens | 当前片段的 Token 数量 |
retrievalCount | 当前片段被检索命中的次数 |
status | 当前片段状态 |
最终:
text
Knowledge
   ↓
Document
   ↓
Segment
   ↓
Embedding / Vector Store
   ↓
检索
   ↓
Chat Prompt
这就是当前知识库与聊天能够结合起来的基础。
芋道通用审计字段
还有一部分字段你不会直接在每一个 AI DO 中看到。
原因是绝大多数对象都继承了:
java
BaseDOBaseDO 当前统一提供:
text
createTime
updateTime
creator
updater
deleted
其中 deleted 使用 MyBatis Plus 的逻辑删除。
所以实际数据库表还会有:
text
业务字段
+
创建时间
+
更新时间
+
创建人
+
更新人
+
逻辑删除
这一套组合。
这是整个 RuoYi Vue Pro 的通用工程规范,我们后续也要遵守。
AI 模块现在实现了哪些能力
知道数据表以后,我们再回头看功能就会清楚很多。
模型管理与多平台接入
目前已经有比较明确的:
text
API Key 管理
Model 管理
Chat Role 管理
Tool 管理
模型枚举中也已经定义了 DeepSeek、通义、OpenAI、Anthropic、Gemini、Ollama、豆包、硅基流动等多个平台。
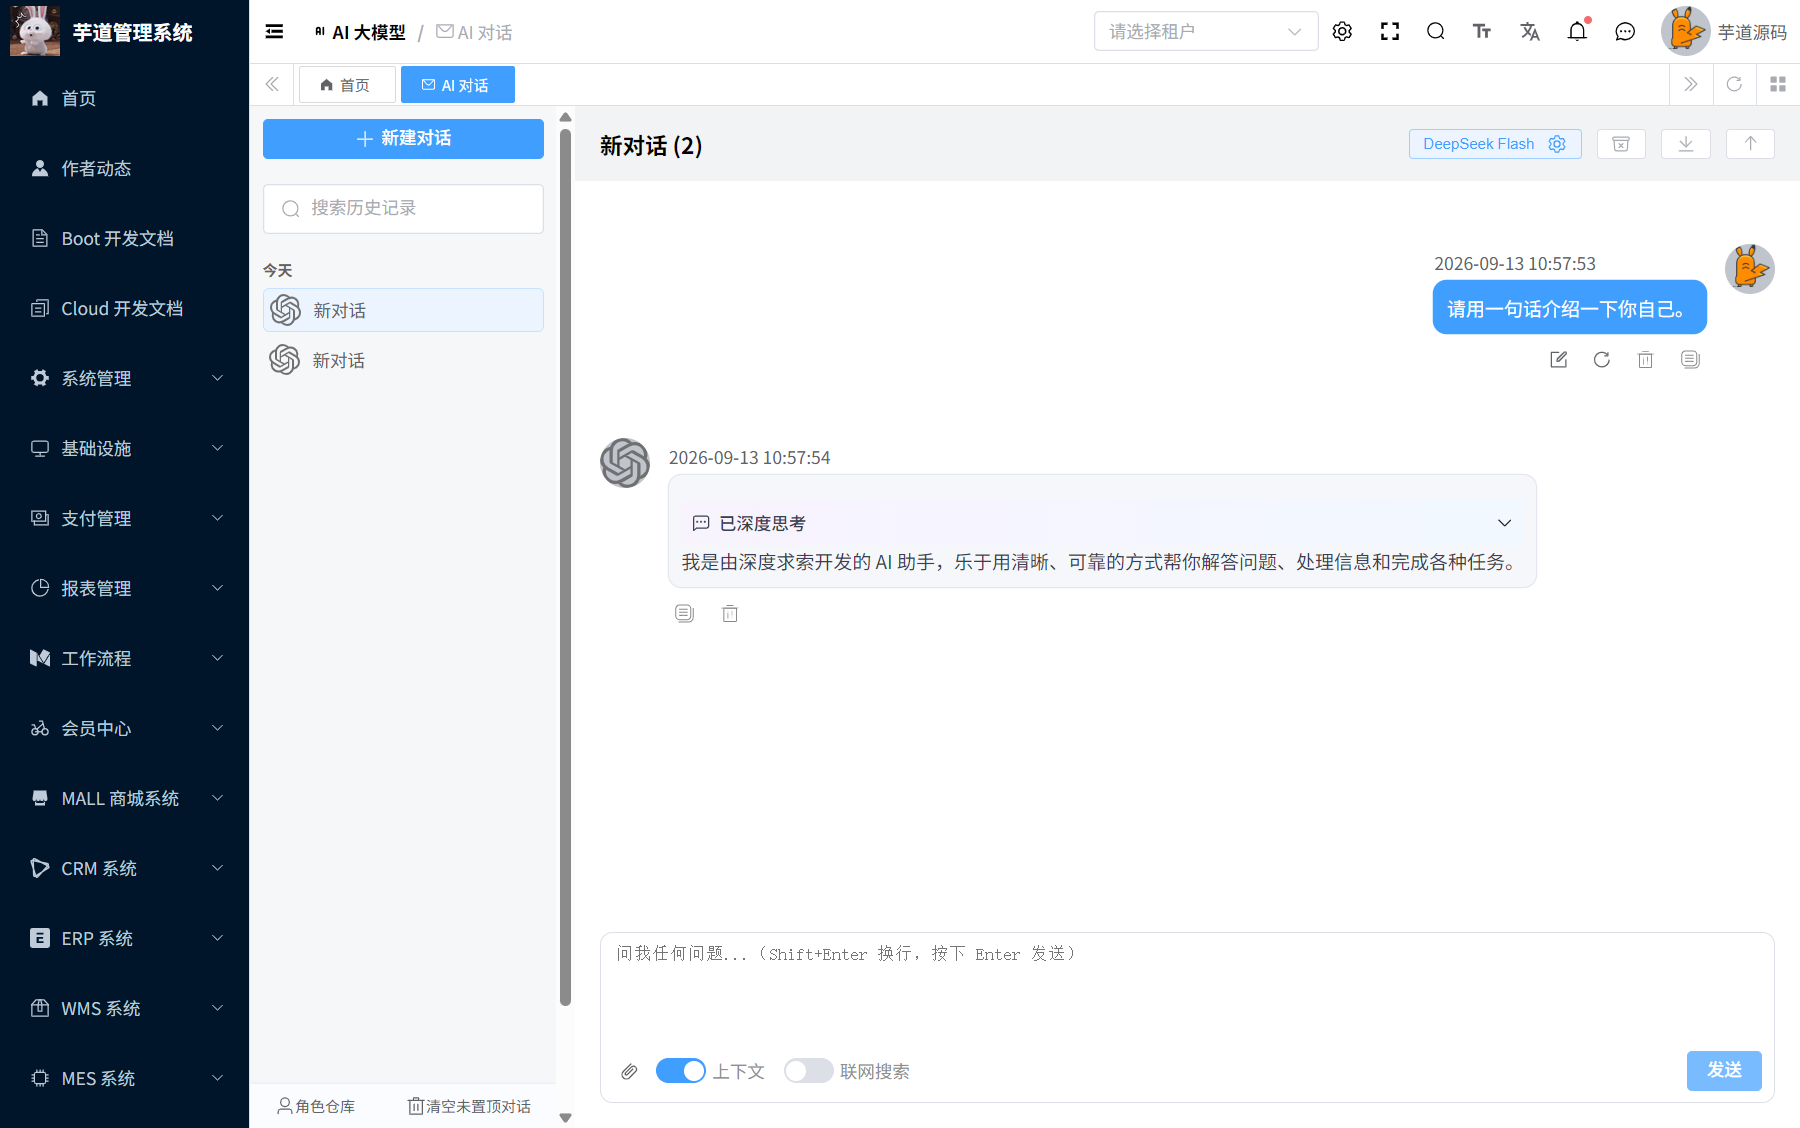
AI 聊天
Chat 是目前我们最熟悉的一块。
上一节已经实际跑通过:
text
新建对话
选择模型
发送消息
SSE 流式响应
聊天记录落库
前端聊天页面本身还已经包含:
text
历史对话
角色
上下文
附件
联网搜索
模型设置
等能力。
后端发送消息时,还能够继续执行:
text
历史上下文
知识库召回
联网搜索
Tool
MCP
等逻辑,再构建 Prompt 调用模型。
因此当前 Chat 已经不是简单的一层:
java
chatModel.call("hello")封装。
它已经形成一套真正的聊天业务。
知识库与 RAG
知识库这一块已经具备:
text
Knowledge
Document
Segment
Retrieval
几个明确层次。
后端聊天代码也已经真正会根据对话配置召回知识片段,并把检索结果加入模型上下文,而不是只有一个孤立的知识库管理页面。
所以从当前源码可以确认:
RAG 已经进入聊天真实调用链。
图片、音乐、写作与思维导图
例如:
text
Image
→ prompt / 模型 / 尺寸 / task / 图片 URL

Music
→ 歌词 / 风格 / 音频 / 视频 / task

Write
→ 原文 / Prompt / 长度 / 格式 / 语气 / 语言

MindMap
→ Prompt / 模型 / 生成内容
因此这些能力已经具备实际业务结构,这个部分现在不太建议去深入了解,后续再看源码就行。
Workflow、Tool 与 MCP
Tool 当前已经有 ai_tool 表,而且聊天角色可以直接关联多个:
text
toolIdsMCP 则通过:
text
mcpClientNames关联 Spring AI MCP Client。
聊天 Service 里也已经存在可选的 MCP Client 注入和 Tool Callback 处理。
Workflow 则已经使用:
text
TinyFlow作为执行能力。
不过项目中仍然存在一些 TODO ,明显仍处于持续演进阶段。
这些能力目前实现到什么程度
| 能力 | 当前代码可以确认的状态 |
|---|---|
| API Key / Model 管理 | 已有完整数据模型、接口和管理页面 |
| AI Chat | 已有真实模型调用、SSE、对话持久化、上下文等完整主链 |
| Chat Role | 已能组合模型、Prompt、知识库、Tool、MCP |
| Knowledge / RAG | 已有知识库、文档、分段、检索,并接入 Chat |
| Image | 已有独立业务、任务状态和结果记录 |
| Music | 已有独立业务和异步任务数据模型 |
| Write | 已有独立业务和生成结果记录 |
| MindMap | 已有独立业务和结果记录 |
| Tool | 已有 Tool 数据模型,并进入聊天角色配置 |
| MCP | 已进入聊天调用设计,但客户端主要来自配置而不是数据库 |
| Workflow | 已有 Graph、CRUD 和 TinyFlow 执行链,但仍明显在演进 |
注意,这些业务能力其实我不太建议现在深入研究,我个人认为其中一些功能的企业级设计还不够成熟。后续很多能力我们都会建立新的模块来独立实现,比如 RAG 模块,以及后续的 Agent 模块。
CostFlow 最需要关注哪些数据
现在重新看回我们的项目。
这 14 张表里面,CostFlow 并不需要每张都深入研究。
现阶段最值得关注的是:
text
ai_api_key
ai_model
ai_chat_conversation
ai_chat_message
因为我们刚刚完成的第一次真实模型请求,主要就经过这些数据。
我们不可能因为新增一个计费统计功能来修改 Music 或者 其他模块的数据库表。
一次模型调用现在已经记录了什么
现在系统实际上已经能够告诉我们:
text
谁发起了消息
→ userId

属于哪个对话
→ conversationId

使用哪个模型
→ modelId / model

用户发了什么
→ content

模型回复了什么
→ content / reasoningContent

是否使用上下文
→ useContext

是否引用知识库
→ segmentIds

是否使用联网搜索
→ webSearchPages

什么时候发生
→ createTime
这些数据其实已经非常接近一次 AI 调用记录的业务上下文。
但是继续查看代码:
text
AiChatMessageDO会发现里面并没有:
text
inputTokens
outputTokens
totalTokens

inputCost
outputCost
totalCost

计费状态
价格版本
账本记录
这些信息。
这正是后面需要我们继续完善的地方。
交给 Coding Agent
这篇同样适合让本地 Agent 带着我们做一次“AI 模块代码导览”。
下一步
现在我们已经知道:
text
AI 模块有哪些能力
        ↓
用了哪些数据库表
        ↓
一次聊天已经保存了什么
        ↓
又明显缺少什么
但目前我们看到的仍然只是:
text
入口
+
最终数据库结果
中间真正调用模型的那段代码,还没有拆开。
下一篇,我们就沿着上一篇已经真实跑通的请求,从浏览器里的:
text
/ai/chat/message/send-stream开始,一直追到 Spring AI 和模型响应:
一条 AI 消息是怎么跑完的:追踪完整模型调用链