

Appearance
1.1.1 RAG 是什么?
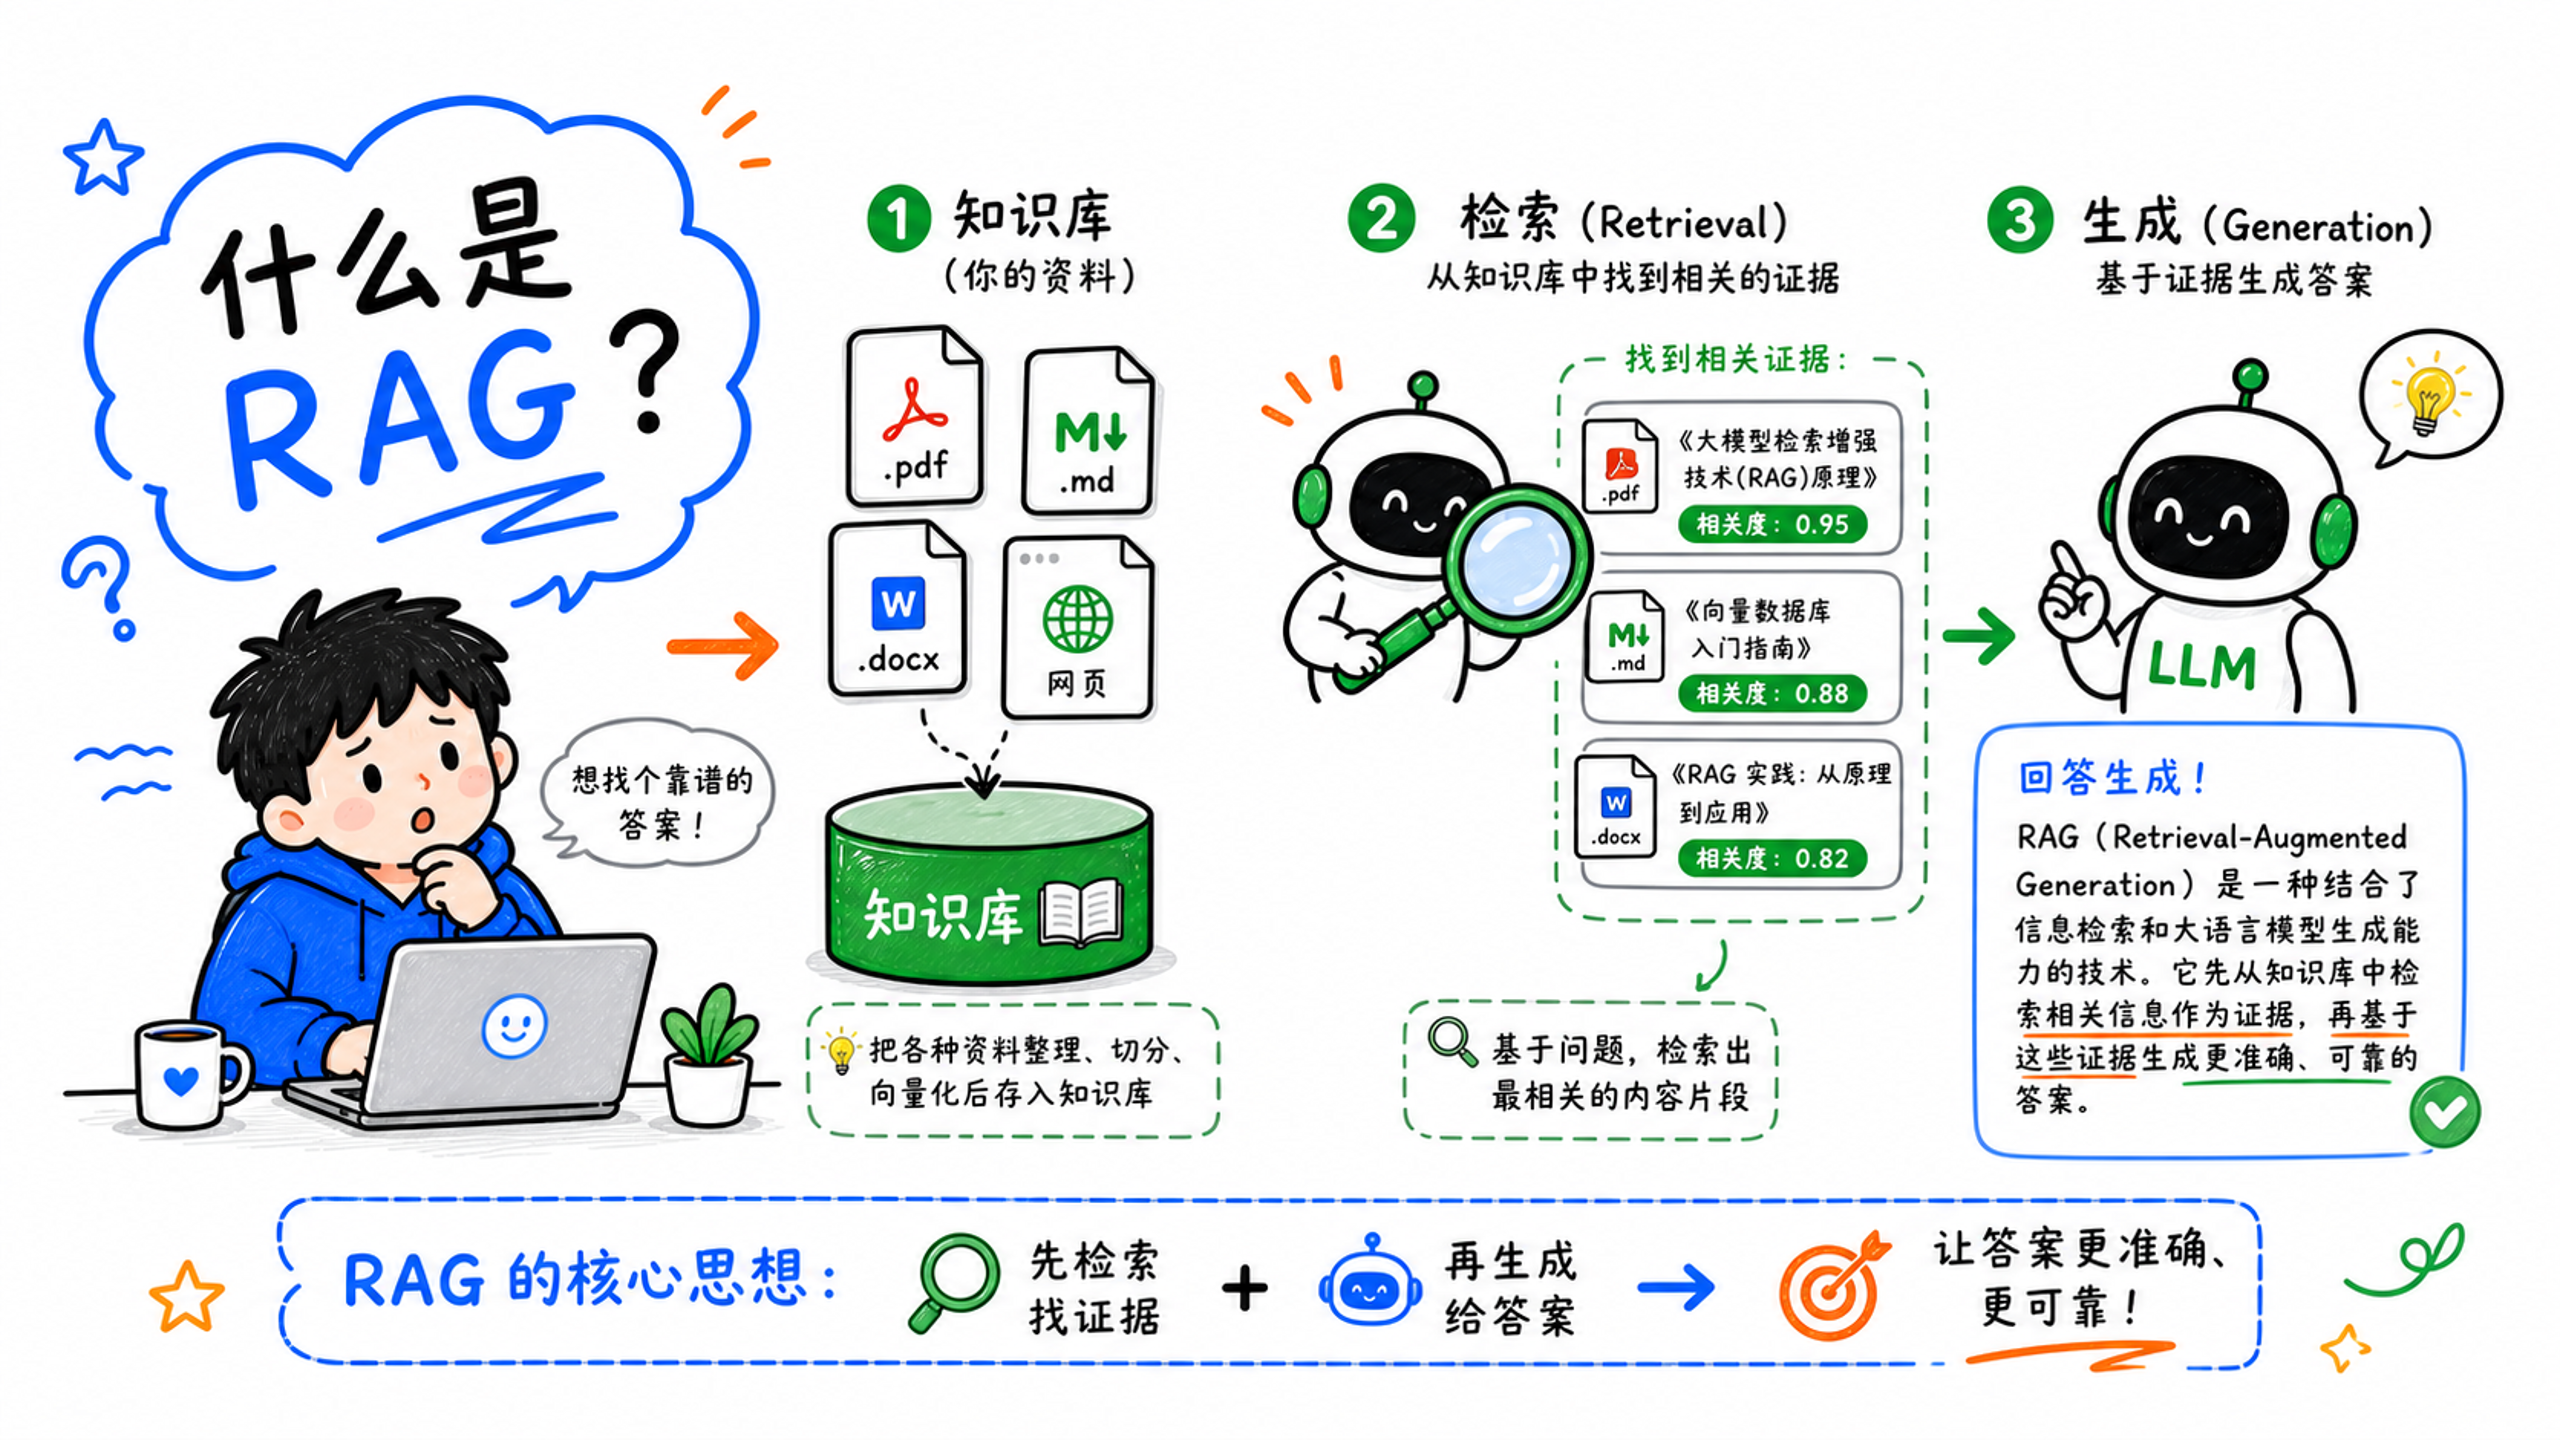
RAG 是 Retrieval-Augmented Generation 的缩写,中文通常叫“检索增强生成”。它的核心思路很简单:先从外部知识源里找到和问题最相关的内容,再把这些内容连同用户问题一起交给大模型生成答案。
如果只看一句话,可以把 RAG 理解成:
让模型在回答之前,先查资料,再基于资料作答。
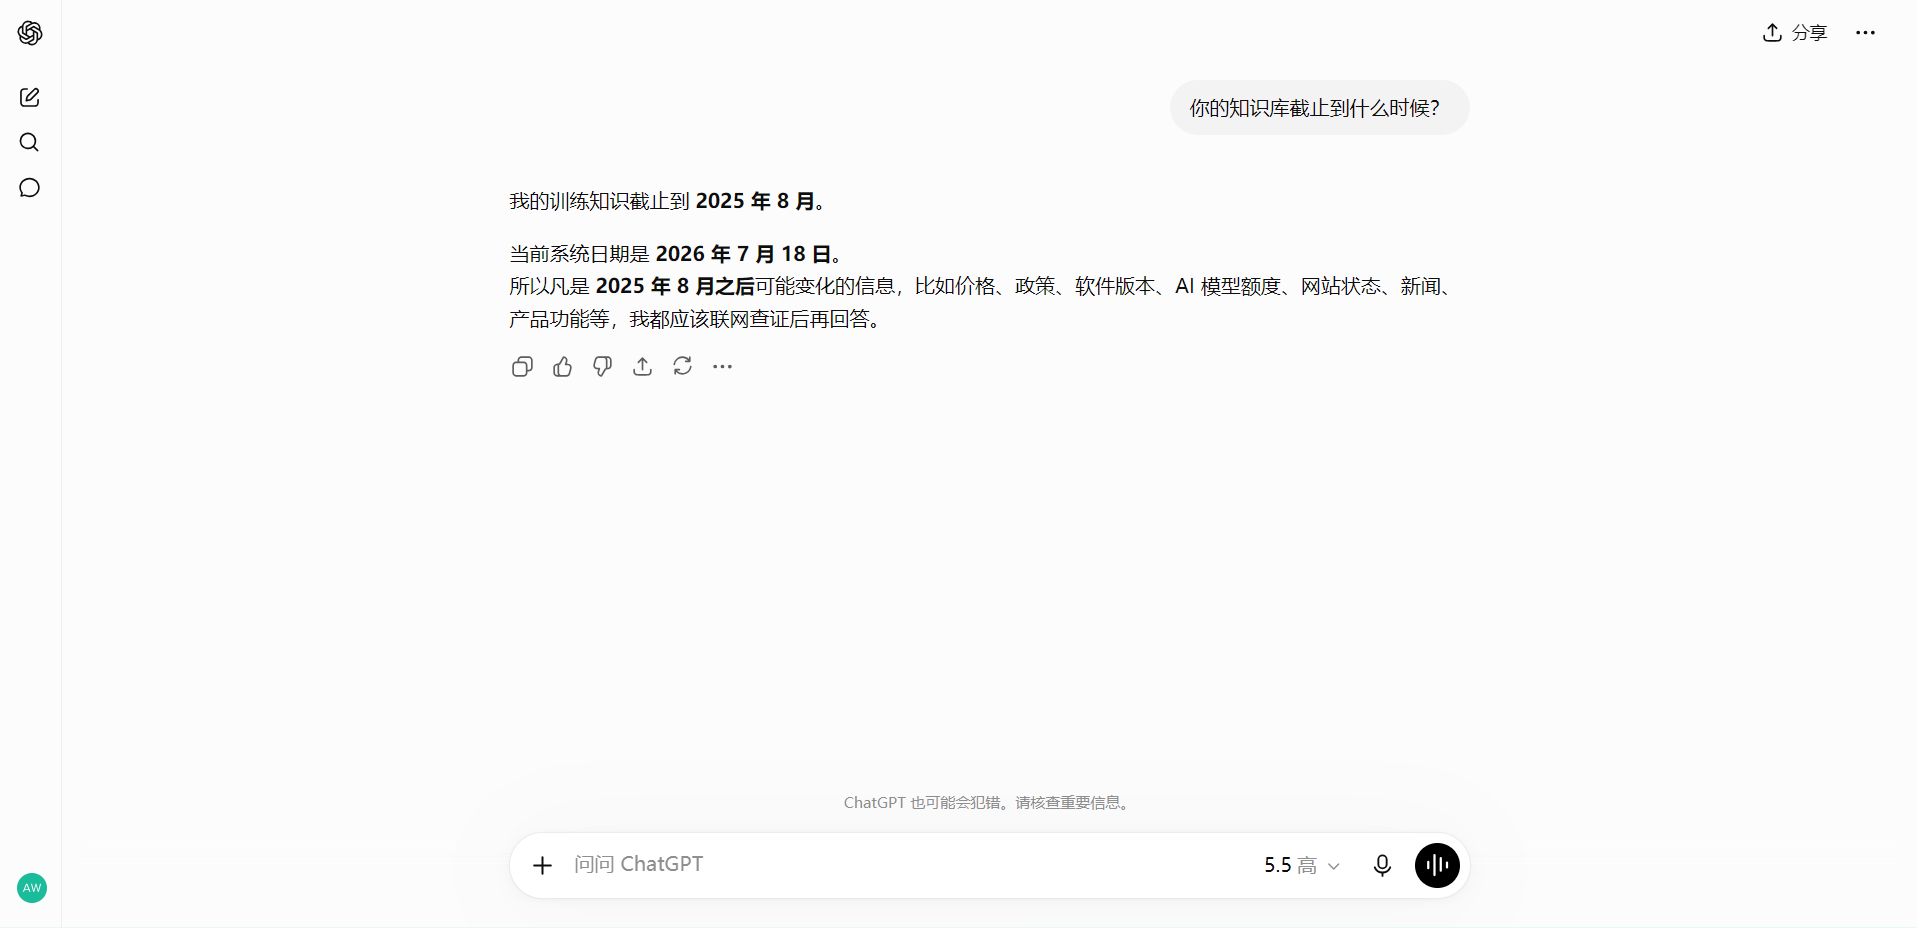
RAG在当前阶段之所以重要,是因为大模型本身的知识主要来自训练阶段。训练完成后,模型的内部知识就基本固定了。它可能不知道最新信息,也不知道你的私有文档、内部流程、产品细节和业务术语。RAG 的作用,就是把这部分"模型原本不知道,或者知道得不够准"的信息,在回答时临时补进来。
RAG 的核心组成是什么
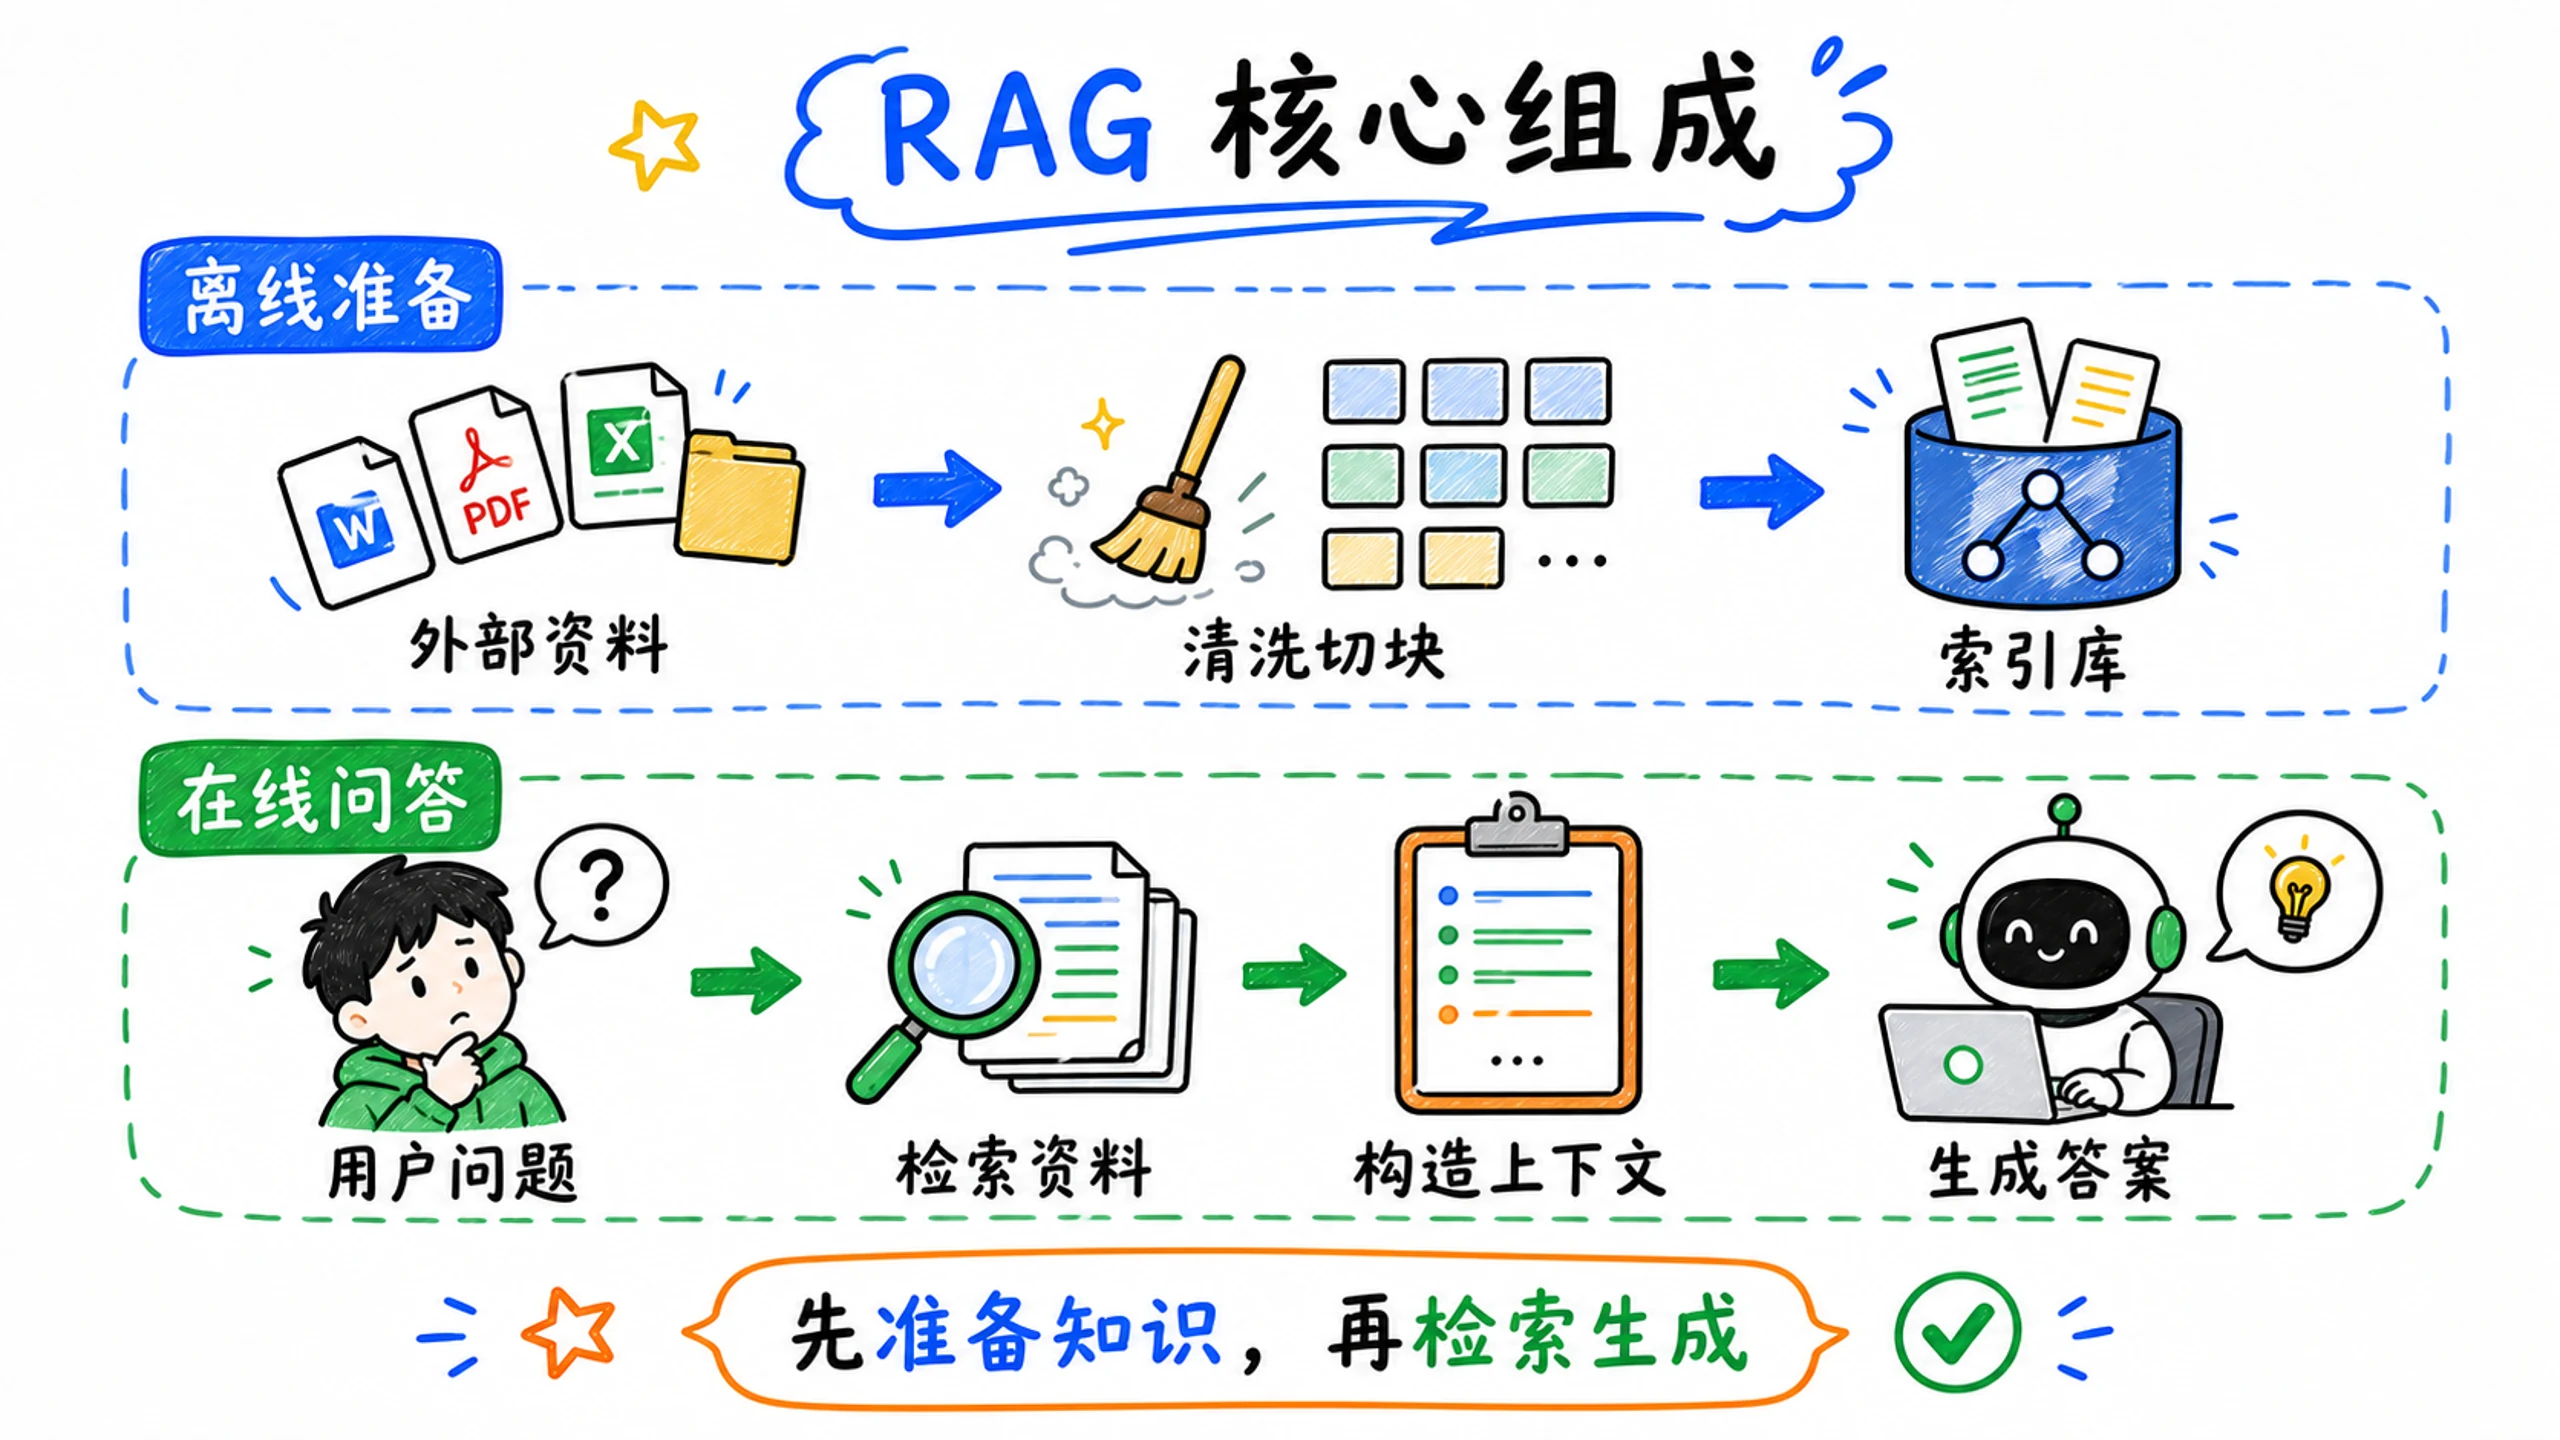
一个典型的 RAG 系统,整体上分为离线和在线两个阶段,通常包含下面几步:
- 准备外部知识,比如文档、网页、FAQ、代码库或数据库内容。
- 把这些内容处理成更适合检索的形式,比如切块、补充元数据、建立索引。
- 当用户提问时,先从知识库里检索出相关内容。
- 把检索结果和用户问题一起组织成上下文。
- 让大模型基于这些上下文生成答案。
所以 RAG 不是某一个单点技术,而是一条完整链路。检索只是其中一环,生成也只是其中一环。真正的效果,取决于整条链路能不能协同起来。
一个最小化的代码示意
先用一段代码感受一下 RAG 在做什么:
python
# 仅示意:省略了具体框架、鉴权、异常处理和持久化

# 这个算是我们提前构建的知识库
knowledge_base = [
    "退款规则:商品签收后 7 天内支持无理由退货。",
    "发票规则:电子发票会在支付完成后 24 小时内开具。",
    "配送规则:偏远地区配送时间可能延长 2 到 3 天。"
]

# 这是一个简单的检索函数,根据关键词匹配返回最相关的文档
def retrieve(query: str, docs: list[str], top_k: int = 2) -> list[str]:
    keywords = [word for word in ["退款", "发票", "配送", "无理由退货"] if word in query]
    scored: list[tuple[int, str]] = []
    for doc in docs:
        score = sum(1 for word in keywords if word in doc)
        scored.append((score, doc))
    scored.sort(reverse=True)
    return [doc for _, doc in scored[:top_k]]


def generate_answer(query: str, contexts: list[str]) -> str:
    context_block = "\n".join(f"- {item}" for item in contexts)
    return f"问题:{query}\n参考资料:\n{context_block}\n\n请只基于参考资料回答。"


query = "退款可以几天内无理由退货?"
contexts = retrieve(query, knowledge_base)
prompt = generate_answer(query, contexts)
print(prompt)
这段代码还远远不是真正可用的 RAG,但它已经把最核心的三件事表现出来了:
- 先准备外部知识
- 再检索相关内容
- 最后基于内容生成回答
这里的 retrieve 只是一个便于理解流程的极简示意。真实系统里的检索,通常会比这个复杂得多,可能会用到:
- 关键词检索
- 向量检索
- metadata 过滤
- 混合检索
所以读这段代码时,重点不是记住“具体这样实现检索”,而是先理解 RAG 的最小工作顺序。
为什么 RAG 会成为大模型应用里的常见方案
RAG 常见,不是因为它“高级”,而是因为它很实用。很多真实业务场景都同时有下面几种需求:
- 需要用到最新信息
- 需要接入私有知识
- 需要降低幻觉
- 需要让回答更容易追溯来源
这几件事,单靠基础模型往往做不好。模型可能会“说得像对”,但并不一定真的基于可靠资料。RAG 的价值就在于,它把“回答”和“证据”绑得更紧,让答案尽量建立在外部资料之上。
思考与讨论
在未来,随着基础模型越来越强大,你认为 RAG 会继续成为大模型应用里的常见方案吗?会有一个方案替代它吗?你有什么设想呢?大胆想象!
RAG 不等于万能
理解 RAG 时,一个很重要的前提是:RAG 的本质是给模型补充可检索的外部知识,而不是替代所有能力建设。
如果问题本身不需要外部知识,比如纯文本改写、风格模仿、分类打标签、固定格式抽取,那么 RAG 就不一定是重点。相反,如果问题高度依赖外部资料,尤其是依赖最新资料、私有资料或可引用资料,那么 RAG 往往会很有价值。
你可以先这样记住 RAG
第一次接触 RAG 时,可以先记住三个关键词:
外部知识:答案不只来自模型参数检索:系统会先去找相关资料生成:模型会基于资料组织语言并输出答案
后面你会看到,真正决定 RAG 质量的,不只是“有没有资料”,而是“资料能不能被找到、能不能被用好、能不能稳定支撑生成”。