

Appearance
1.1.3 为什么大模型应用里经常需要 RAG?
大模型应用里经常需要 RAG,核心原因不是“大模型不够强”,而是大模型再强,也天然有几个边界。
最常见的边界包括:
- 它的知识有时间截断
- 它默认不知道你的私有数据
- 它可能知道一些通用知识,但不一定知道得足够准
- 它能生成自然语言,但不一定能说明答案依据来自哪里
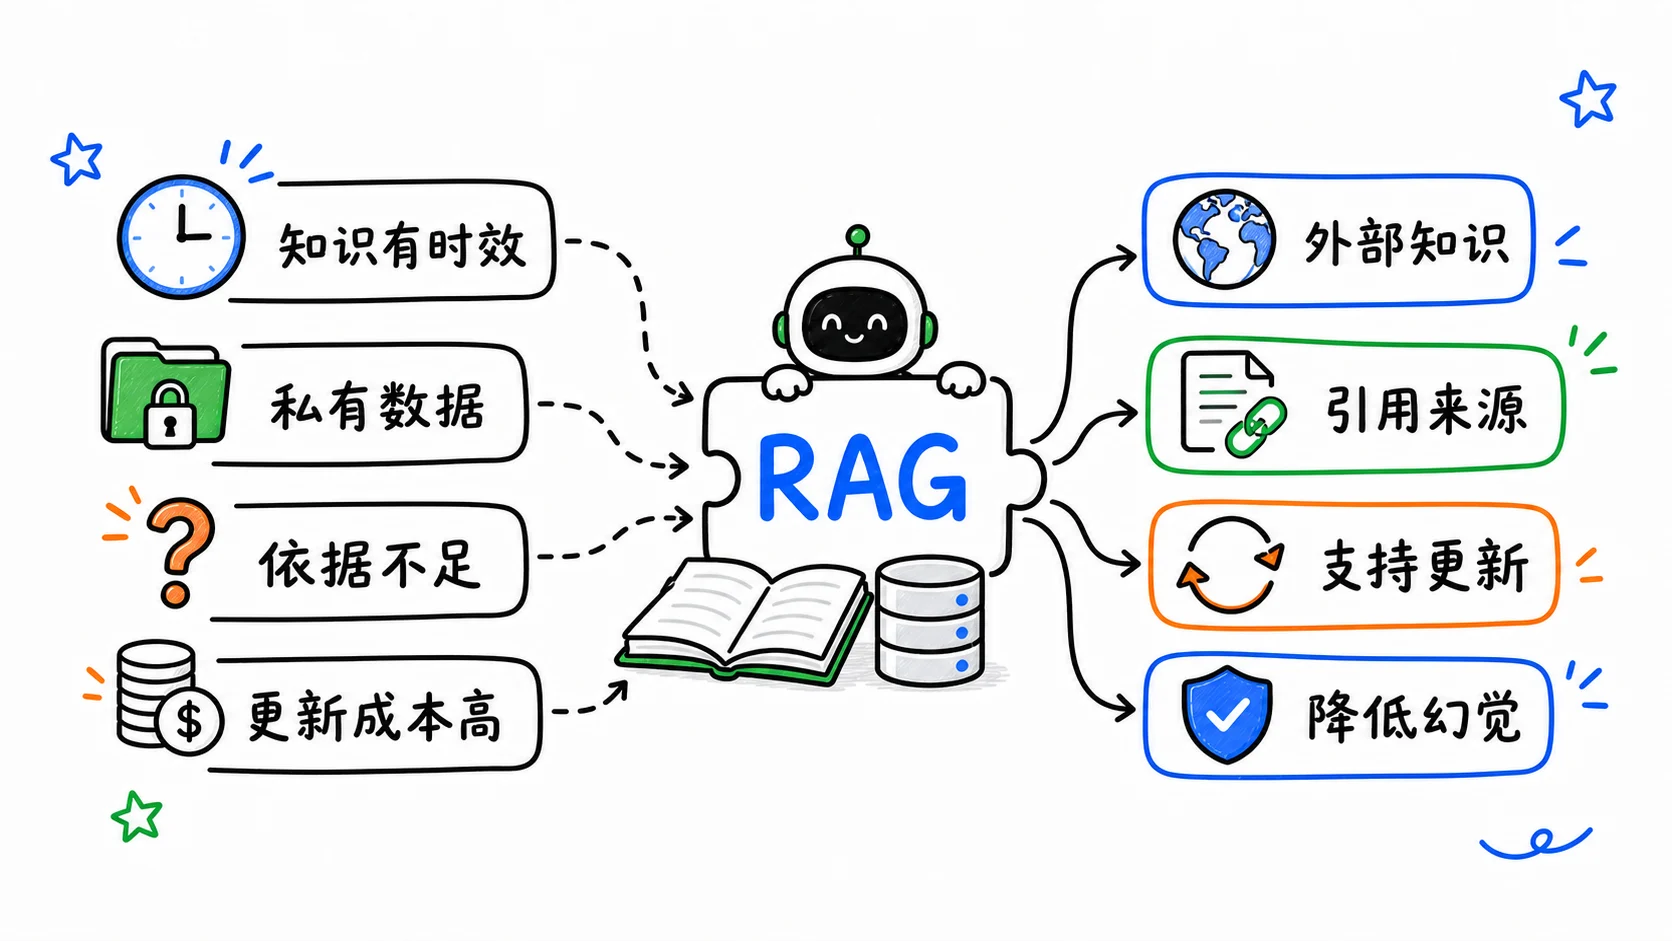
而很多真实应用,恰恰最在意的就是这些问题。
第一个原因:模型知识不是实时更新的
大模型的知识主要来自训练数据。训练结束以后,模型内部知识就相对固定了。
这意味着一旦问题依赖最新信息,比如:
- 最近发布的产品文档
- 刚更新的业务规则
- 最近一周的新闻事件
- 新上线的接口或配置
模型就可能答得过时,甚至一本正经地答错。RAG 的意义就在于把“外部最新资料”接到回答链路里,让模型不是只靠旧记忆作答。
第二个原因:模型默认不知道你的私有知识
通用模型不会天然知道你的公司制度、产品手册、客户协议、内部 Wiki、代码规范、操作手册和历史工单。
而很多业务应用最重要的价值,恰恰来自这些私有知识。
比如:
- 内部知识问答
- 客服助手
- 企业搜索问答
- 研发文档助手
- 运维和流程助手
这些场景里,模型如果不能用到私有资料,就很难真正落地。RAG 正好提供了一种不改模型参数、但能接入私有知识的方式。
第三个原因:模型需要“依据”,不只是“答案”
很多应用不是只想让模型说一句像样的话,而是希望它说得:
- 更准确
- 更相关
- 更容易核验
如果用户问的是事实性问题,系统最好不仅给结论,还能告诉用户依据是什么。RAG 很适合这类需求,因为它天生和外部证据链更接近。
这也是为什么很多企业场景会很在意:
- 引用来源
- 来源可追溯
- 回答是否忠于材料
- 资料不足时能不能明确说不知道
这些诉求,本质上都在推动系统从“纯生成”走向“基于检索的生成”。
第四个原因:RAG 往往比重新训练更灵活
如果问题的本质是“知识要更新”,那直接去改模型通常并不划算。
因为知识类问题的变化很频繁,重新微调或重新训练的成本往往更高,维护也更麻烦。相比之下,RAG 只需要更新知识库和索引,就能让系统回答建立在新资料上。
所以在很多应用里,RAG 的吸引力不是“最强”,而是“更灵活、更现实”。
为什么你会频繁看到 RAG
因为很多高价值场景都符合下面这个模式:
- 用户问题来自真实业务
- 业务答案依赖外部资料
- 外部资料经常更新
- 用户希望答案尽量可靠
只要这四点同时出现,RAG 基本就会成为一个自然选项。
可以先这样理解
大模型擅长的是语言理解和语言生成,RAG 擅长的是把外部知识及时接进来。
所以很多应用真正需要的,不是让模型“记住一切”,而是让模型在该回答的时候,知道去哪里找、找什么、怎么基于资料回答。
一个对比代码示意
下面这段极简示意,可以帮助你直观看到“纯模型回答”和“先检索再回答”的区别:
python
def answer_with_model_only(query: str) -> str:
    return f"直接让模型回答:{query}"


def filter_active_docs(kb: list[dict]) -> list[dict]:
    return [
        doc for doc in kb
        if doc["metadata"]["status"] == "active"
    ]


def answer_with_rag(query: str, kb: list[dict]) -> str:
    active_docs = filter_active_docs(kb)

    # 这里只是示意:真实系统里通常会在这里做检索,而不是直接遍历列表
    retrieved = [
        doc["text"] for doc in active_docs
        if doc["metadata"]["topic"] == "refund_policy"
    ][:1]
    context = "\n".join(retrieved)
    return f"问题:{query}\n参考资料:\n{context}\n\n请只基于参考资料作答。"


knowledge_base = [
    {
        "text": "2026 年新版退款规则:签收后 7 天内支持无理由退货。",
        "metadata": {"version": "v3", "status": "active", "topic": "refund_policy"}
    },
    {
        "text": "旧版退款规则:签收后 15 天内支持无理由退货。",
        "metadata": {"version": "v2", "status": "expired", "topic": "refund_policy"}
    }
]

query = "现在退款规则是什么?"

print(answer_with_model_only(query))
print(answer_with_rag(query, knowledge_base))
这段示意代码虽然很短,但已经体现了一个关键区别:
- 纯模型回答时,答案主要依赖模型内部已有知识
- RAG 回答时,答案会先建立在当前知识库内容上
这里故意只把“当前有效版本”送进上下文,而不是把所有相关文本一股脑拼进去。因为真正想体现的重点是:
- RAG 的价值不只是“查到资料”
- 而是“尽量把当前最该使用的资料送给模型”
这里用 status、topic 这样的显式元数据来区分“当前可用版本”和“文档主题”,比直接靠正文里有没有“新版”几个字要合理得多。因为真实系统里的版本控制和检索过滤,通常依赖的是:
- 元数据状态
- 生效时间
- 版本号
- 检索过滤规则
如果把新旧版本、冲突版本和无关版本都一起塞进去,模型仍然可能回答得很混乱。这也是为什么后面会专门讲知识治理、版本控制和上下文构造。